Arsitektur Monitoring Stack
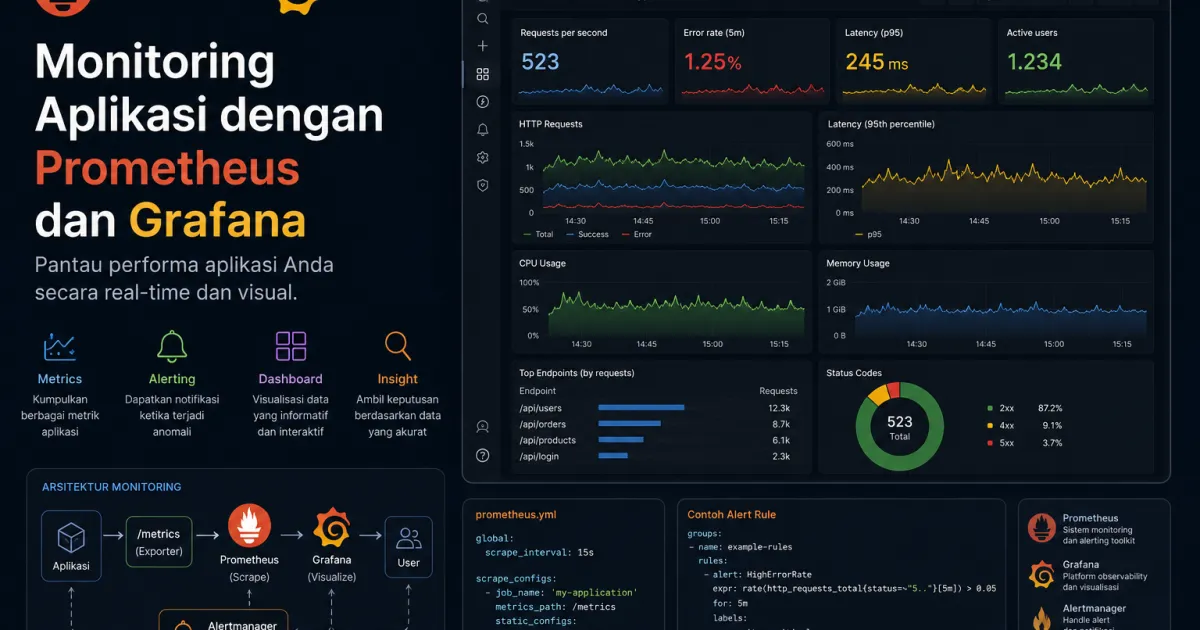
Monitoring aplikasi dapat menggunakan kombinasi Prometheus, Grafana, dan AlertManager. Prometheus mengambil metrics dari aplikasi secara berkala, Grafana menampilkan data dalam bentuk dashboard, sedangkan AlertManager mengirimkan notifikasi ketika kondisi tertentu terpenuhi.
Instrumentasi Node.js
Untuk aplikasi Node.js, gunakan library prom-client untuk mengumpulkan metrics. Aplikasi dapat menyediakan endpoint seperti /metrics yang kemudian dibaca oleh Prometheus.
Metrics bawaan dapat digunakan untuk memantau penggunaan CPU, memory, dan event loop, sehingga kondisi aplikasi lebih mudah dipantau.
Custom Metrics
Selain metrics bawaan, tambahkan custom metrics sesuai kebutuhan aplikasi:
-
Counter: jumlah request dan error
-
Histogram: durasi request dan distribusi latency
-
Gauge: koneksi aktif dan jumlah antrean
Custom metrics membantu tim memahami perilaku aplikasi secara lebih spesifik.
Setup Prometheus
Buat file prometheus.yml untuk menentukan endpoint aplikasi yang akan di-scrape.
Prometheus juga dapat dijalankan menggunakan Docker:
docker run -v ./prometheus.yml:/etc/prometheus/prometheus.yml prom/prometheusPastikan endpoint /metrics dapat diakses oleh Prometheus dari jaringan yang digunakan.
Dashboard Grafana
Hubungkan Grafana dengan Prometheus sebagai data source, kemudian buat dashboard untuk menampilkan kondisi aplikasi secara real-time.
Gunakan pendekatan RED metrics sebagai dasar monitoring:
-
Request Rate: jumlah request
-
Error Rate: persentase request yang gagal
-
Duration: waktu respons aplikasi
Dashboard dapat dikembangkan sesuai kebutuhan sistem dan karakteristik traffic.
Alerting
Buat alert berdasarkan kondisi yang membutuhkan perhatian tim, misalnya error rate lebih dari 1%, p95 latency di atas 500 ms, atau penggunaan memory lebih dari 80%.
Notifikasi dapat diintegrasikan dengan Slack, PagerDuty, atau platform incident management lainnya agar tim dapat segera merespons masalah.
Logging dan Tracing
Metrics sebaiknya dilengkapi dengan logs dan distributed tracing. Metrics menunjukkan bahwa masalah terjadi, sementara logs dan traces membantu menemukan penyebabnya.
Kombinasi ketiganya membuat proses troubleshooting dan analisis incident menjadi lebih efektif.
Kesimpulan
Prometheus dan Grafana menyediakan fondasi monitoring yang kuat untuk aplikasi Node.js. Dengan instrumentasi yang tepat, dashboard yang informatif, dan alerting yang terukur, tim dapat mendeteksi masalah lebih cepat dan menjaga stabilitas aplikasi.