Apa Itu Chaos Engineering?
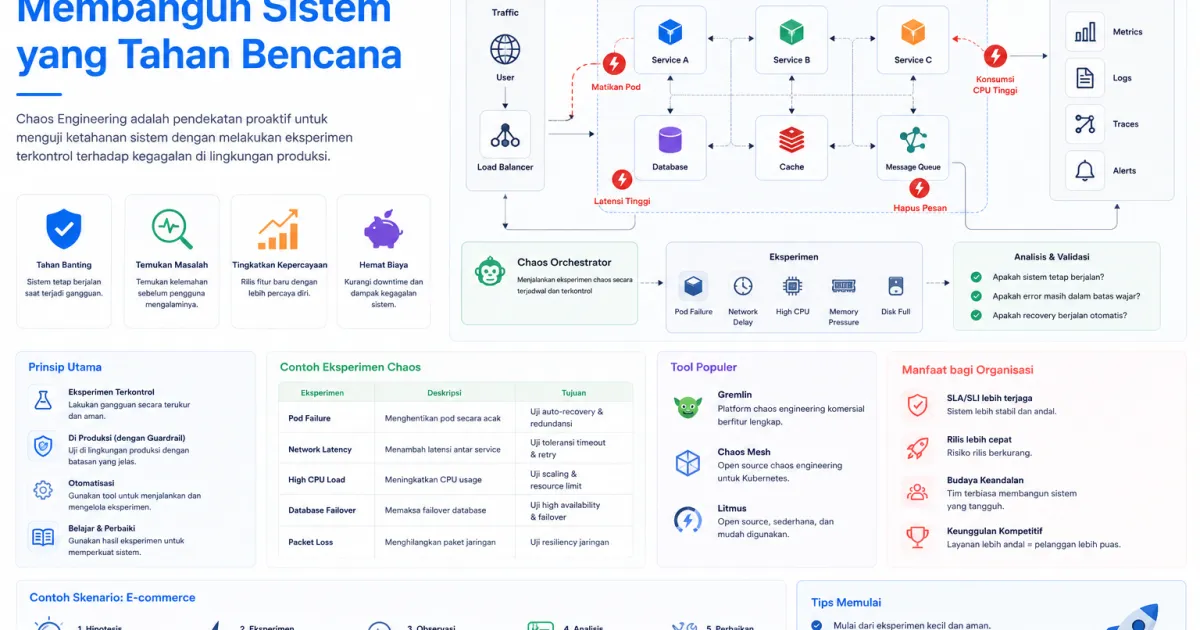
Chaos engineering adalah praktik menguji ketahanan sistem dengan sengaja menciptakan kondisi atau gangguan tertentu. Tujuannya bukan merusak sistem, tetapi menemukan kelemahan sebelum masalah tersebut terjadi saat insiden nyata.
Dengan pengujian yang terkontrol, tim dapat mengetahui apakah aplikasi benar-benar mampu bertahan ketika menghadapi kegagalan infrastruktur, gangguan jaringan, atau peningkatan beban.
Prinsip Dasar Chaos Engineering
Eksperimen chaos engineering sebaiknya dilakukan secara terstruktur:
-
Definisikan steady state — tentukan kondisi normal sistem berdasarkan metrics yang dapat diukur.
-
Buat hipotesis — misalnya, “aplikasi tetap tersedia ketika satu node database mengalami kegagalan.”
-
Inject failure — buat gangguan seperti mematikan replica, menambahkan network latency, atau membatasi resource.
-
Amati hasil — periksa apakah sistem tetap berada dalam kondisi yang diharapkan.
-
Evaluasi — jika hipotesis gagal, gunakan hasil eksperimen untuk memperbaiki sistem.
Tools Chaos Engineering
Beberapa tools dapat membantu menjalankan eksperimen chaos secara lebih terstruktur.
Chaos Monkey dari Netflix dikenal untuk menguji ketahanan aplikasi terhadap kegagalan instance. Untuk lingkungan Kubernetes, Litmus dapat digunakan untuk menjalankan berbagai eksperimen. Sementara itu, Chaos Toolkit menawarkan pendekatan open source yang fleksibel untuk berbagai platform.
Organisasi dengan kebutuhan enterprise juga dapat mempertimbangkan platform seperti Gremlin.
Game Days
Game day adalah simulasi insiden di mana tim secara sengaja membuat kondisi failure dan berlatih menangani dampaknya.
Misalnya, tim dapat mensimulasikan database down, service tidak dapat diakses, atau network latency meningkat. Selain menguji sistem, game day membantu menemukan kekurangan pada monitoring, alerting, runbook, dan incident response.
Memulai Chaos Engineering dengan Aman
Chaos engineering harus dilakukan secara bertahap. Untuk eksperimen awal, gunakan staging environment dan failure dengan dampak terbatas.
Contohnya, matikan satu replica terlebih dahulu dan pastikan sistem mampu melakukan recovery. Setelah proses berjalan dengan baik, eksperimen dapat diperluas secara bertahap sesuai tingkat kematangan sistem.
Jika eksperimen dilakukan di production, gunakan scope yang jelas, monitoring aktif, rollback plan, dan batas dampak agar risiko tetap terkendali.
Kesimpulan
Chaos engineering membantu mengubah ketidakpastian menjadi pengetahuan yang dapat ditindaklanjuti. Dengan menguji kegagalan secara terkontrol, tim dapat menemukan kelemahan lebih awal dan membangun sistem yang lebih tangguh sebelum menghadapi insiden nyata.