Mengapa Probabilistic Data Structures?
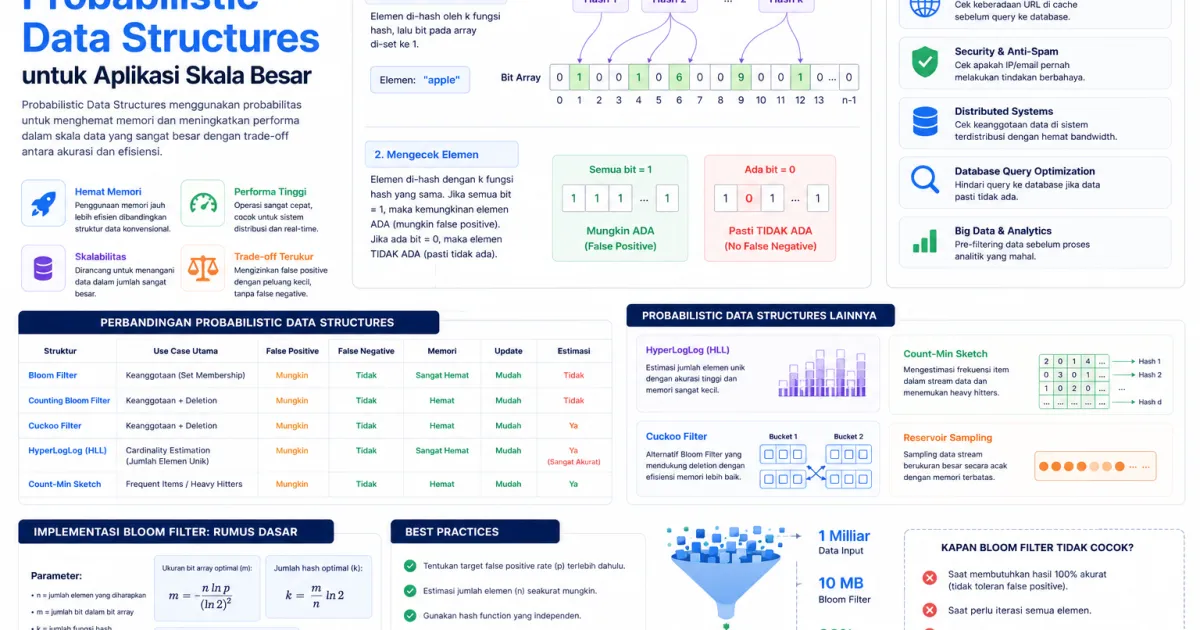
Ketika aplikasi harus menangani jutaan hingga miliaran data, struktur data konvensional seperti HashSet dapat membutuhkan memori yang sangat besar.
Probabilistic data structures menawarkan pendekatan yang lebih hemat resource dengan menerima tingkat kesalahan tertentu yang dapat dikontrol. Struktur ini sangat berguna ketika kecepatan dan efisiensi memori lebih penting daripada akurasi absolut.
Bloom Filter
Bloom Filter digunakan untuk menjawab pertanyaan sederhana: “Apakah data ini pernah ada?”
Hasilnya memiliki dua kemungkinan:
-
Pasti tidak ada — hasil ini akurat.
-
Mungkin ada — dapat terjadi false positive.
Bloom Filter tidak menghasilkan false negative, sehingga cocok digunakan sebagai pemeriksaan awal sebelum melakukan operasi yang lebih mahal.
Contohnya, sistem dapat memeriksa Bloom Filter terlebih dahulu sebelum melakukan database atau disk lookup. Jika data dipastikan tidak ada, pencarian yang lebih mahal dapat dilewati.
Teknik ini banyak digunakan dalam sistem database, caching, dan distributed systems.
HyperLogLog
HyperLogLog (HLL) digunakan untuk memperkirakan jumlah elemen unik atau cardinality dari dataset yang sangat besar.
Keunggulannya adalah penggunaan memori yang sangat kecil dibandingkan menyimpan seluruh elemen unik. HLL cocok untuk kebutuhan seperti menghitung unique visitor, jumlah pengguna aktif, atau distinct query dalam dataset berukuran besar.
Redis juga menyediakan implementasi HyperLogLog melalui perintah seperti PFADD dan PFCOUNT.
Count-Min Sketch
Count-Min Sketch digunakan untuk memperkirakan frekuensi kemunculan suatu elemen tanpa harus menyimpan seluruh data yang masuk.
Struktur ini cocok untuk data berbentuk stream yang terus bertambah, misalnya menghitung seberapa sering sebuah keyword muncul.
Beberapa penerapannya antara lain trending topics, traffic analysis, rate limiting, dan fraud detection.
Kapan Menggunakan?
Bloom Filter cocok untuk cache pre-check, pengecekan awal username, atau menghindari lookup database yang tidak diperlukan.
HyperLogLog cocok untuk menghitung jumlah data unik seperti visitor, pengguna, atau aktivitas tertentu tanpa menyimpan seluruh daftar elemen.
Count-Min Sketch lebih sesuai untuk memperkirakan frekuensi data seperti keyword populer, event yang sering terjadi, atau pola transaksi mencurigakan.
Pertimbangan Sebelum Menggunakan
Probabilistic data structures bukan pengganti struktur data biasa untuk semua kebutuhan. Karena menggunakan pendekatan estimasi, setiap struktur memiliki trade-off antara akurasi, penggunaan memori, dan performa.
Pastikan tingkat error yang dihasilkan masih dapat diterima oleh kebutuhan bisnis sebelum menerapkannya ke production.
Kesimpulan
Probabilistic data structures membantu menangani data berskala besar dengan penggunaan resource yang jauh lebih efisien. Bloom Filter, HyperLogLog, dan Count-Min Sketch memiliki fungsi berbeda, tetapi semuanya dapat menjadi solusi efektif ketika struktur data konvensional mulai menghadapi keterbatasan skala.